정확도 95%인 모델도 드문 종을 모두 놓칠 수 있습니다. 전체 사진에서 흔한 종이 95%를 차지한다면, 모든 사진을 그 종이라고 답해도 정확도는 95%가 되기 때문입니다. 드문 종을 찾으려는 목적이라면 전체 정확도보다 그 종을 얼마나 놓쳤는지 먼저 확인해야 합니다.
이 글은 제공된 scikit-learn 공식 문서 발췌문 중 분류 보고서와 확률 보정 설명을 해설합니다. 아래 종명 A·B와 모든 평가 수치는 직접 만든 가상 예제이며, 실제 미세조류 모델의 검증 성과가 아닙니다. 사진마다 정답 라벨 하나와 예측 라벨 하나가 있다고 가정합니다.
정확도 95%를 혼동행렬로 풀어봅니다
평가 사진 100장 중 실제 A종은 95장, B종은 5장이라고 가정합니다. 모델은 모든 사진을 A종으로 예측합니다. 여기서 B종은 이 평가 자료에서 수가 적은 종을 뜻하며, 생태학적으로 희귀하다는 의미는 아닙니다.
혼동행렬은 실제 라벨과 예측 라벨을 교차한 표입니다. 아래에서는 행이 실제 라벨, 열이 예측 라벨입니다. 숫자의 단위는 사진 장수입니다.
| 실제 라벨 | A종으로 예측 | B종으로 예측 | 실제 표본 수 |
|---|---|---|---|
| A종 | 95 | 0 | 95 |
| B종 | 5 | 0 | 5 |
| 예측 합계 | 100 | 0 | 100 |
정답은 대각선에 있는 95장과 0장입니다.
전체 정확도 = (95 + 0) ÷ 100 = 95%
그러나 실제 B종 5장은 모두 A종으로 잘못 분류됐습니다. 따라서 이 결과로 ‘B종을 찾는 성능이 좋다’고 판단할 수 없습니다. 전체 정확도는 종의 구성 비율에 영향을 받으므로, 서로 다른 평가 자료의 정확도를 비교할 때도 종별 장수를 함께 봐야 합니다.
정밀도와 재현율은 분모가 다릅니다
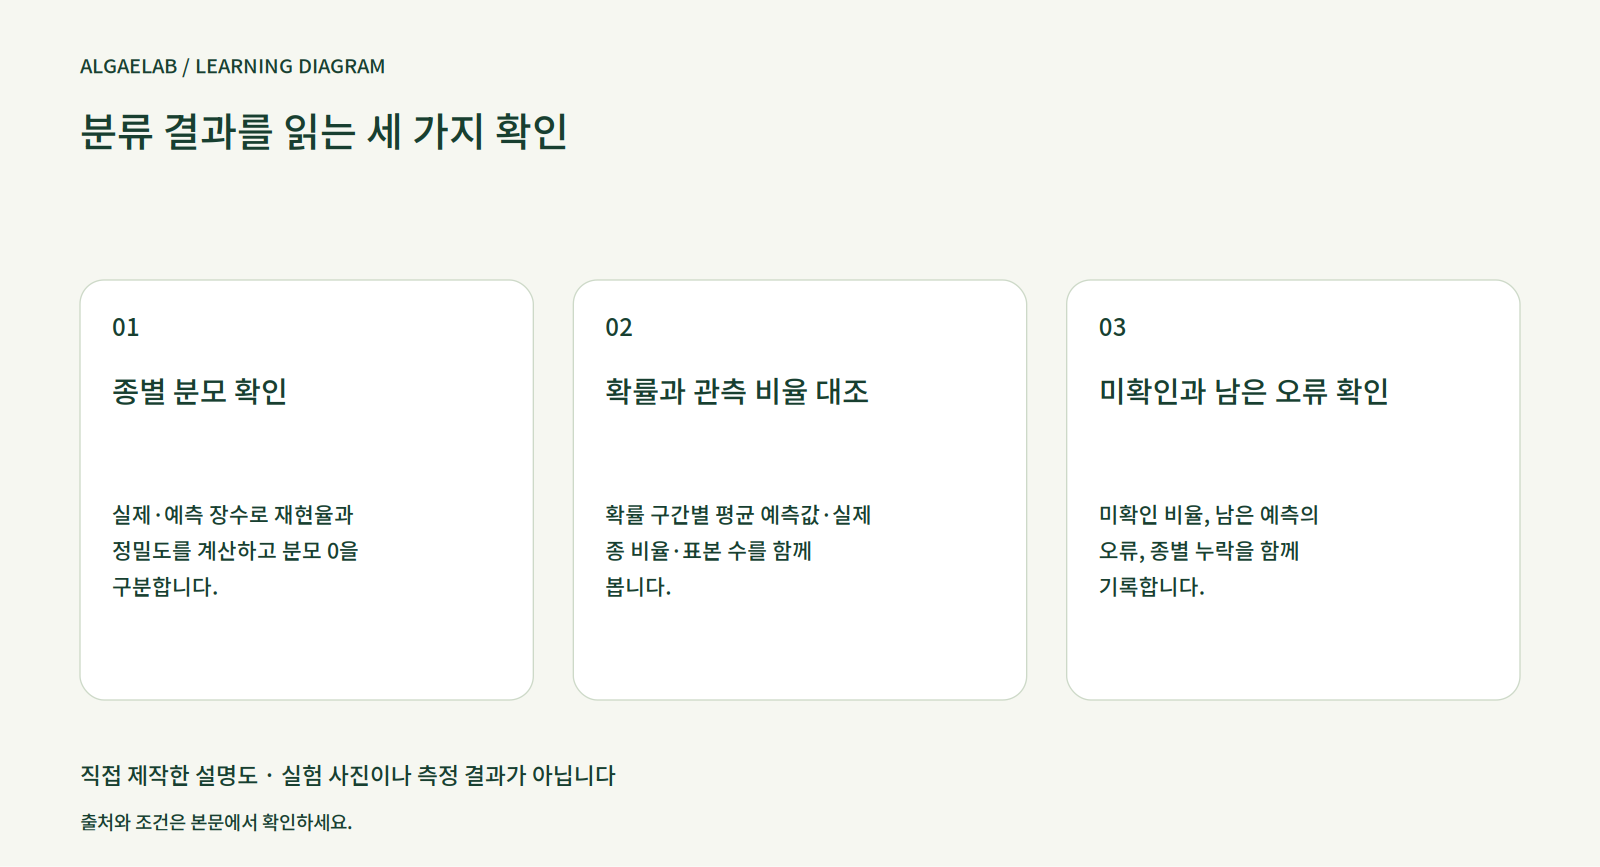
정밀도는 특정 종이라고 예측한 사진 중 실제로 그 종인 비율입니다. 재현율은 실제 그 종인 사진 중 모델이 그 종으로 맞힌 비율입니다. 종별로 다음과 같이 계산합니다.
- 정밀도 = 해당 종을 맞힌 장수 ÷ 해당 종으로 예측한 장수
- 재현율 = 해당 종을 맞힌 장수 ÷ 실제 해당 종의 장수
- 표본 수(support) = 실제 해당 종의 장수
위 혼동행렬에 적용하면 다음 결과가 나옵니다.
| 종 | 정밀도 계산 | 재현율 계산 | 실제 표본 수 |
|---|---|---|---|
| A종 | 95 ÷ 100 = 95% | 95 ÷ 95 = 100% | 95 |
| B종 | 0 ÷ 0 = 정의되지 않음 | 0 ÷ 5 = 0% | 5 |
A종의 재현율 100%는 모든 A종 사진을 찾았다는 뜻입니다. 하지만 B종 사진까지 A종이라고 답했으므로 A종 정밀도는 95%입니다.
B종 정밀도는 분모가 0입니다. B종이라고 예측한 사진 자체가 없으므로, 그 예측이 얼마나 정확했는지 비율을 계산할 수 없습니다. 이를 ‘B종 정밀도 100%’로 해석해서는 안 됩니다. 반면 B종 재현율은 실제 B종 5장이 있으므로 계산할 수 있으며, 값은 0%입니다.
scikit-learn의 classification_report 문서는 종별 정밀도·재현율·F1 점수·표본 수를 보고하며, 0으로 나누는 경우의 반환값을 zero_division으로 정한다고 설명합니다. 기본값인 "warn"은 0을 반환하면서 경고도 발생시킵니다. 보고서에 0이 표시됐더라도, 계산 가능한 비율이 실제로 0인지, 분모가 없어 대신 표시한 값인지 구분해야 합니다.
평균 점수 옆에 종별 장수를 남깁니다
같은 예제에서 두 종의 재현율을 동일한 비중으로 평균하면 다음과 같습니다.
종별 재현율의 단순 평균 = (100% + 0%) ÷ 2 = 50%
실제 표본 수로 가중 평균하면 결과가 달라집니다.
표본 수 가중 재현율 = (95 × 100% + 5 × 0%) ÷ 100 = 95%
공식 문서는 종별 값을 같은 비중으로 평균하는 방식을 macro average, 실제 표본 수로 가중하는 방식을 weighted average라고 설명합니다. 이 예제에서는 가중 평균에도 A종의 큰 비중이 반영됩니다. 평균 하나만 제시하기보다 종별 결과를 함께 남겨야 B종 누락이 보입니다.
표본 수도 점수 해석의 일부입니다. 별도의 가상 예제에서 B종 5장 중 4장을 찾았다면 재현율은 80%이고, 5장을 모두 찾았다면 100%입니다. 사진 한 장 차이가 20%포인트를 바꿉니다. 5장 중 5장을 맞힌 결과와 500장 중 500장을 맞힌 결과를 같은 크기의 근거로 취급하지 말고, 분자와 분모를 함께 기록합니다. 실제 B종이 0장인 평가에서는 B종 재현율 자체를 계산할 수 없습니다.
화면의 ‘80%’는 별도로 확인합니다
확률 숫자와 분류 정확도는 서로 다른 질문에 답합니다. 정확도는 선택한 라벨이 얼마나 맞았는지, 확률 보정은 표시한 확률과 실제 발생 비율이 얼마나 대응하는지를 묻습니다.
scikit-learn의 확률 보정 문서는 잘 보정된 이진 분류기의 경우, 양성 클래스 확률이 약 0.8인 표본들에서 실제 양성 비율도 약 80%여야 한다고 설명합니다. 여기서는 ‘A종인가, 아닌가’를 이진 분류로 생각할 수 있습니다. 이는 비슷한 확률을 받은 표본 집단에 관한 설명이며, 개별 사진의 종 동정을 확정하는 의미는 아닙니다.
가상 확인 예제: A종 확률이 0.75 이상 0.85 미만인 사진 50장을 모았고, 평균 예측 확률은 0.80이라고 가정합니다. 실제 A종은 35장이라면 관측된 A종 비율은 다음과 같습니다.
실제 A종 비율 = 35 ÷ 50 = 70%
이 구간에서는 평균 예측 80%보다 관측 비율이 10%포인트 낮습니다. 다만 이 구간의 50장만으로 모델 전체의 보정 상태를 확정하지는 않습니다. 다른 확률 구간에서도 평균 예측 확률, 실제 해당 종의 비율, 장수를 함께 확인해야 합니다. 종별 확률의 보정을 볼 때는 각 종을 ‘해당 종인가, 아닌가’로 구분해 기록할 수 있습니다.
확률 보정 절차를 적용했다는 기록만으로 결과가 충분히 보정됐다고 판단하지 않습니다. 공식 문서는 보정에 사용하는 자료를 분류기 학습 자료와 독립적으로 마련해야 하는 이유도 설명합니다. 평가 보고서에서는 보정 방법과 별도 평가 결과가 제시됐는지 확인합니다.
미확인으로 보낸 사진까지 분모에 넣습니다
확률이 낮은 사진을 ‘미확인’으로 보내는 규칙은 검토 경로를 만들 수 있습니다. 그러나 미확인 사진을 제외하고 정확도만 계산하면, 얼마나 많은 사진을 처리하지 못했는지 가려집니다. 미확인은 정답을 맞힌 것으로 세지 않고 별도 상태로 기록합니다. 여기서 미확인은 모델의 예측 보류 상태이며, 평가 사진의 정답 라벨이 미확인이라는 뜻은 아닙니다.
처음의 100장 예제에 미확인 규칙을 추가했다고 가정합니다. 실제 A종 7장과 B종 3장을 미확인으로 보내고, 남은 사진 90장은 모두 A종으로 예측합니다. 이는 규칙의 효과를 설명하기 위한 가정이며, 특정 확률 임계값의 실측 결과가 아닙니다.
| 실제 라벨 | A종으로 예측 | B종으로 예측 | 미확인 | 합계 |
|---|---|---|---|---|
| A종 | 88 | 0 | 7 | 95 |
| B종 | 2 | 0 | 3 | 5 |
| 합계 | 90 | 0 | 10 | 100 |
이때 함께 보고할 값은 다음과 같습니다.
- 미확인 비율:
10 ÷ 100 = 10% - 자동 예측을 남긴 비율:
90 ÷ 100 = 90% - 남은 자동 예측의 정확도:
88 ÷ 90 ≈ 97.8% - 남은 자동 예측의 오류율:
2 ÷ 90 ≈ 2.2% - 전체 입력 중 자동 정답 비율:
88 ÷ 100 = 88%
남은 예측의 정확도는 95%에서 약 97.8%로 높아졌지만, 자동으로 맞힌 사진은 95장에서 88장으로 줄었습니다. B종은 여전히 자동 예측으로 한 장도 찾지 못했습니다. B종 3장은 검토 경로로 보냈고, 2장은 A종으로 오분류된 채 남았습니다.
따라서 ‘미확인 기능으로 희귀 종 문제를 해결했다’는 결론은 이 표에서 나오지 않습니다. 사람의 검토까지 포함한 결과를 평가하려면 미확인 10장의 최종 판정과 검토 시간도 별도로 기록해야 합니다. 미확인 경로로 보낸 비율은 종별로도 확인합니다. 이 예제에서는 A종의 7 ÷ 95 ≈ 7.4%, B종의 3 ÷ 5 = 60%입니다.
평가 보고서에 남길 최소 기록
다음 양식은 결과 해석을 위한 제안입니다. 효과가 검증된 평가 도구라는 의미는 아닙니다.
| 기록 항목 | 남길 내용 |
|---|---|
| 평가 단위와 범위 | 사진 한 장당 라벨 수, 평가 자료 식별자, 대상 종 |
| 종별 결과 | 실제 장수, 예측 장수, 정답 장수, 정밀도·재현율 |
| 혼동행렬 | 행·열의 의미, 장수 기준인지 비율 기준인지 |
| 계산 예외 | 분모가 0인 항목과 표시 방식, 평균에 포함한 종 |
| 확률 보정 | 보정 방법·사용 자료, 종별·확률 구간별 평균 예측값、실제 비율、장수 |
| 미확인 처리 | 적용 규칙, 전체·종별 미확인 비율, 남은 예측의 오류 |
| 후속 검토 | 미확인 사진의 최종 판정, 검토 시간, 해결되지 않은 건수 |
목적이 B종 누락을 줄이는 것이라면, 보고서의 첫 질문은 ‘전체 정확도가 높은가’보다 ‘실제 B종 몇 장 중 몇 장을 찾았고, 나머지는 어디로 갔는가’가 됩니다. 모델 라벨과 확률만으로 종 동정이 확정됐다고 판단하지도 않습니다.
자료 수집과 배치별 분리 절차는 미세조류 AI 이미지 분류 — 학습 자료 준비에서 이어 읽을 수 있습니다. 이 글의 출처 검토 범위는 제공된 두 공식 문서 발췌문이며, 두 출처의 제공된 수집 기록 날짜는 모두 2026년 10월 14일입니다. 작성 과정에서 외부 페이지를 추가 조회하거나 실제 모델 실행·미세조류 현장 시험을 수행하지 않았습니다.